موظفة في شركة مقاولات بالقاهرة تريد تلخيص تقرير متابعة من عشرين صفحة. ترفع الملف إلى أداة ذكاء اصطناعي، فيأتي الملخص بأرقام في غير موضعها وجمل لا معنى لها. المشكلة في أحيان كثيرة لا تكون في النموذج اللغوي، بل في الخطوة التي تسبقه: تحويل ملف PDF إلى نص.
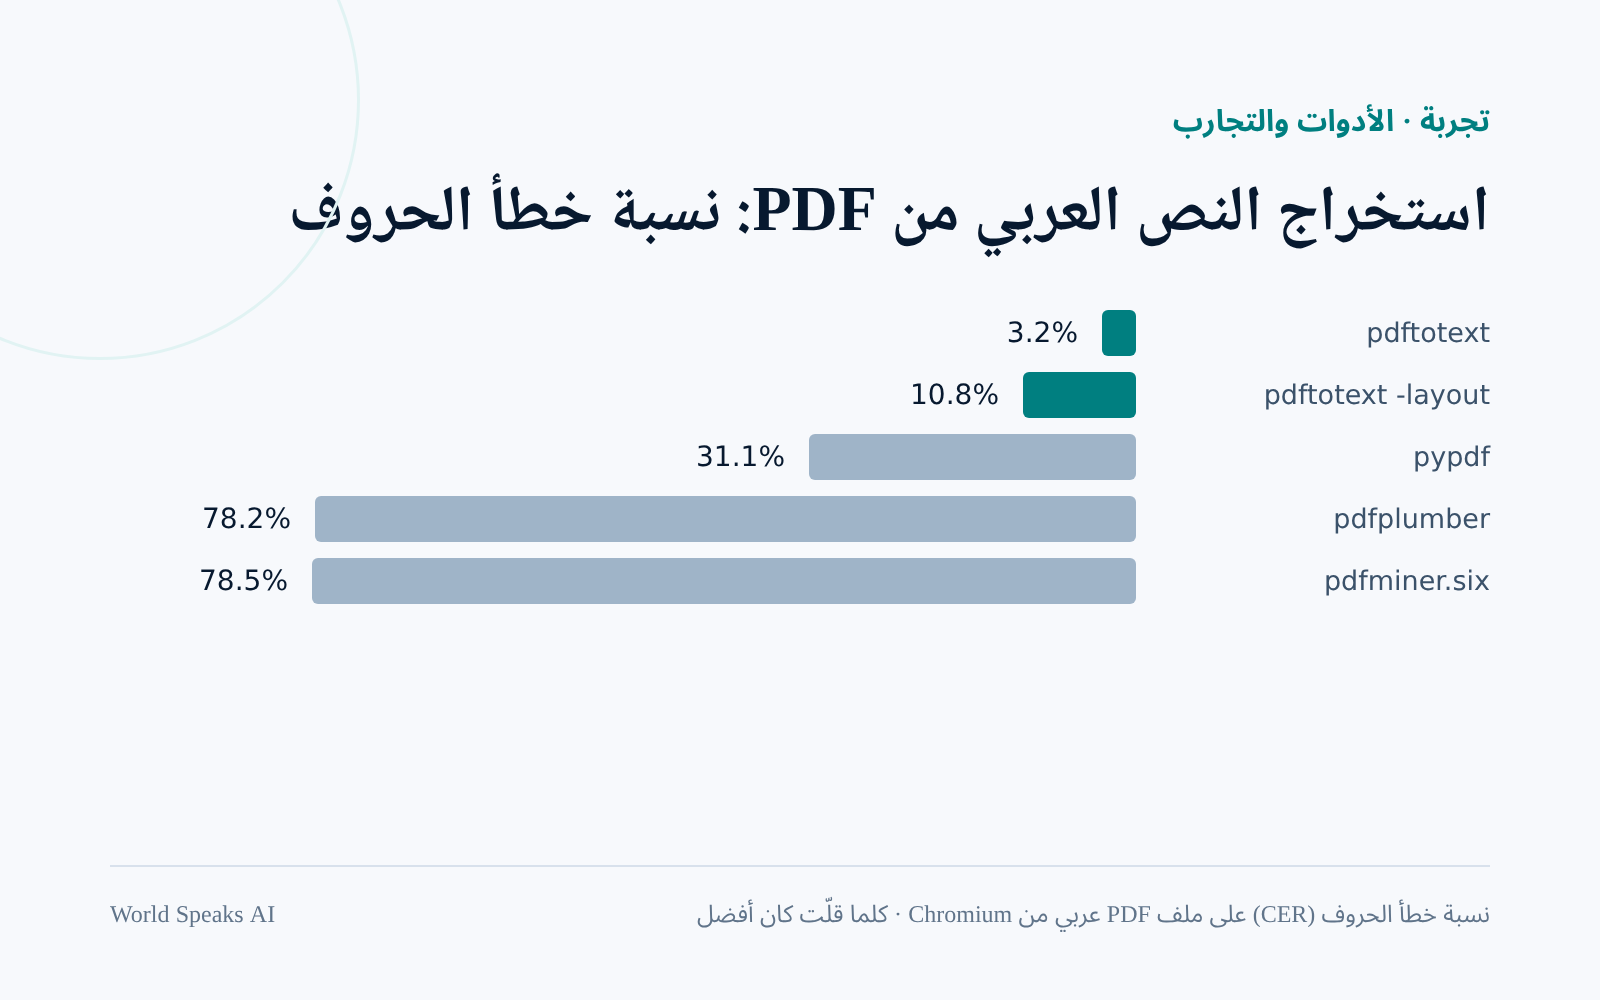
أجرينا في 14 أكتوبر 2026 تجربة على هذه الخطوة تحديدًا. صنعنا صفحة تقرير عربية واحدة بثلاث صيغ PDF، ومررناها على خمس طرق استخراج مفتوحة المصدر، وقسنا نسبة الأخطاء في كل منها. الجواب المختصر: أداة pdftotext من حزمة Poppler أعطت أدق نص، وأداتان شائعتان في بايثون أخرجتا كل سطر عربي معكوس الحروف، والملف الممسوح ضوئيًا لم تخرج منه أي أداة بحرف واحد.
لماذا يهمك هذا قبل أن ترفع ملفًا لأداة ذكاء اصطناعي؟
حين تطلب تلخيص ملف أو الإجابة عن أسئلة منه، فإن كثيرًا من الأدوات والأنظمة المبنية على النماذج اللغوية تستخرج النص أولًا ثم ترسله إلى النموذج. إذا وصل النص معكوسًا أو مختلط الترتيب، فإن النموذج سيحاول فهمه كما هو، وقد يملأ الفجوات بتخمينات مقنعة الشكل.
هذا مهم خصوصًا لمن يبني بنفسه سكربتًا يقرأ ملفات PDF عربية ويرسلها إلى واجهة برمجة، أو لمن يجهز ملفات لنظام بحث داخلي في شركته. خطأ صغير في ترتيب رقم داخل تقرير مالي قد يتحول إلى استنتاج خاطئ في الملخص. ولهذا نوصي دائمًا بمراجعة الملخص كما شرحنا في كيف تراجع إجابة الذكاء الاصطناعي قبل أن تعتمدها.
وللنص المشوه ثمن إضافي: الحروف المعكوسة أو أشكال العرض الخاصة قد تُقطَّع إلى رموز (tokens) أكثر من النص السليم، فتزيد التكلفة وتستهلك نافذة السياق بلا فائدة، كما وضحنا في تجربة كم رمزًا تكلفك العربية.
كيف أجرينا التجربة؟
كتبنا صفحة تقرير عربية قصيرة تمثل وثيقة عمل نموذجية: عنوان «تقرير متابعة مشروع التحول الرقمي»، وأربع فقرات فيها أرقام مثل «68 في المئة» و«15 نوفمبر»، ومصطلح إنجليزي هو REST، وعنوان بريد إلكتروني، وجدول من ثلاثة صفوف وثلاثة أعمدة.
حوّلنا هذه الصفحة إلى ثلاثة ملفات:
- الملف A: صفحة HTML طُبعت إلى PDF عبر متصفح Chromium (من خلال Playwright) بخط Noto Naskh Arabic، وهذا يشبه ما يحدث حين تحفظ صفحة ويب بصيغة PDF.
- الملف B: مستند Word بالاتجاه من اليمين إلى اليسار، أنشأناه بمكتبة python-docx ثم حولناه إلى PDF ببرنامج LibreOffice 24.2.7 بخط Amiri، وهذا يشبه معظم التقارير المكتبية.
- الملف C: نسخة «ممسوحة ضوئيًا» من الملف A، أي صورة فقط بدقة 200 نقطة في البوصة بلا طبقة نصية.
ثم استخرجنا النص بخمس طرق: أداة pdftotext من Poppler الإصدار 24.02.0 بالوضع الافتراضي ومع الخيار -layout، ومكتبة pypdf الإصدار 5.9.0، ومكتبة pdfplumber الإصدار 0.11.10، ومكتبة pdfminer.six الإصدار 20260107.
كيف قسنا الخطأ؟
استخدمنا مقياس معدل خطأ الحروف (CER): عدد عمليات الإضافة والحذف والاستبدال اللازمة لتحويل النص المستخرج إلى النص الأصلي، مقسومًا على طول النص الأصلي. قيمة 0.032 تعني نحو 3 أخطاء في كل 100 حرف، وكلما انخفض الرقم كان أفضل.
قبل المقارنة وحّدنا النصين بثلاث خطوات: تطبيع NFKC، وحذف علامات الاتجاه غير المرئية، ودمج المسافات المتتالية. هذا التوحيد يعني أن الأرقام أدناه متساهلة نسبيًا، فهي لا تحاسب الأداة على علامات خفية يمكن تنظيفها بسهولة.
import re, unicodedata
from rapidfuzz.distance import Levenshtein
def norm(s):
s = unicodedata.normalize("NFKC", s)
s = s.replace("ـ", "")
s = re.sub("[--]", "", s)
return re.sub(r"\s+", " ", s).strip()
def cer(truth, output):
t, o = norm(truth), norm(output)
return Levenshtein.distance(t, o) / len(t)النتائج: فرق كبير بين الأدوات
| الأداة | الملف A من Chromium | الملف B من LibreOffice | الملف C الممسوح |
|---|---|---|---|
| pdftotext | 0.032 | 0.032 | لا نص (0 حرف) |
| pdftotext -layout | 0.108 | 0.108 | لا نص |
| pypdf | 0.311 | 0.086 | لا نص |
| pdfplumber | 0.782 | 0.771 | لا نص |
| pdfminer.six | 0.785 | 0.772 | لا نص |
ثلاث ملاحظات أساسية من الجدول. أولًا، pdftotext بالوضع الافتراضي كان الأدق في الملفين النصيين بالنتيجة نفسها تقريبًا. ثانيًا، pypdf تأثر كثيرًا بمصدر الملف: أداؤه مقبول مع ملف LibreOffice وضعيف مع ملف Chromium. ثالثًا، pdfplumber وpdfminer.six تجاوزا 0.77 في الملفين، وهو مستوى لا يصلح معه النص للاستخدام المباشر.
أما الملف الممسوح فلم تستخرج منه أي أداة شيئًا، وهذا متوقع لأنه صورة بلا طبقة نصية. توثيق pypdf نفسه ينص على أن المكتبة ليست برنامج تعرّف ضوئي على الحروف (OCR)، ويقترح أداة مثل Tesseract لهذه الحالة. حين مررنا الصفحة الممسوحة نفسها على Tesseract 5.3.4 كانت نسبة الخطأ 0.077 بحزمة العربية وحدها و0.068 مع إضافة الإنجليزية.
كيف تبدو الأخطاء فعلًا؟
الأرقام وحدها لا تكفي، فنوع الخطأ يحدد إن كان يمكن إصلاحه. هذه نماذج قصيرة من المخرجات الفعلية.
pdfplumber وpdfminer.six: حروف معكوسة بالكامل
خرج كل سطر عربي معكوس الحروف، فصار عنوان التقرير هكذا:
يمقرلا لوحتلا عورشم ةعباتم ريرقتوالمقصود «تقرير متابعة مشروع التحول الرقمي». لاحظ أن الأرقام والكلمات الإنجليزية مثل 68 وREST وعنوان البريد بقيت في اتجاهها الصحيح، وهذا ما يجعل الإصلاح بعكس السطر كاملًا فكرة سيئة: ستُصلح العربية وتُفسد الأرقام. وفي الملف A كانت الحروف أيضًا بأشكال العرض الخاصة لا بالحروف العربية الأساسية.
pypdf: الحروف سليمة والأرقام في المكان الخطأ
حافظت pypdf على ترتيب الحروف العربية، لكنها نقلت الأرقام والكلمات اللاتينية إلى مواضع خاطئة. في الملف A ظهر هذا السطر:
في المئة حتى68عقد فريق المشروع اجتماعه الأسبوعي يوم الأحدالرقم 68 التصق بكلمة «عقد» وانتقلت عبارة «في المئة حتى» إلى بداية السطر. كما التصقت خلايا الجدول بلا مسافات فصارت «المهمةالمسؤولالموعد»، وظهرت الحروف في الملف A بأشكال العرض الخاصة.
pdftotext: أفضل نص مع عيوب صغيرة
النص الأدق جاء من pdftotext، لكنه أضاف علامات اتجاه غير مرئية حول كل سطر، ووضع علامة الترقيم أحيانًا ملاصقة للكلمة التالية بدل السابقة كما في « ،وناقش»، وألصق بعض الأرقام بما بعدها مثل «15نوفمبر»، وأخرج خلايا الجدول كل خلية في سطر مستقل. أما مع -layout فقد حافظ على شكل الأعمدة بإضافة مسافات كثيرة، لكن رؤوس الجدول خرجت بترتيبها البصري من اليسار: «الموعد المسؤول المهمة».
لماذا يحدث هذا؟ الترتيب المنطقي والترتيب البصري
يفرّق معيار يونيكود للنص ثنائي الاتجاه UAX #9 بين أمرين: الترتيب المنطقي وهو ترتيب الحروف كما تُكتب وتُخزن في الذاكرة، وترتيب العرض وهو ما تراه العين على الشاشة بعد تطبيق خوارزمية الاتجاه. النص العربي الصحيح يُخزن بالترتيب المنطقي، والخوارزمية هي التي تقلبه للعرض.
ملف PDF لا يخزن غالبًا «نصًا» بالمعنى الذي نعرفه، بل يخزن أشكال حروف (glyphs) في مواضع محددة على الصفحة. حين تقرأ أداة الاستخراج الحروف من اليسار إلى اليمين حسب إحداثياتها، فهي تقرأ الترتيب البصري، فينقلب السطر العربي. الأدوات التي تعيد بناء الترتيب المنطقي بنجاح هي التي تفهم اتجاه النص، وهذا ما يفسر الفرق بين pdftotext والأداتين المعكوستين.
ولاحظ أن مستودع pdfplumber يذكر خيارات اتجاه مثل char_dir وline_dir تقبل القيمة rtl. لم نختبر هذه الخيارات في تجربتنا، فاستخدمنا الإعدادات الافتراضية، لذا قد تتحسن نتيجة pdfplumber إذا ضُبطت، وهذا يستحق التجربة على ملفاتك.
أشكال العرض الخاصة
للحرف العربي أشكال متعددة حسب موقعه: منفصل وأول الكلمة ووسطها وآخرها. يونيكود يحتوي على رموز مستقلة لهذه الأشكال، يسميها معيار التطبيع UAX #15 أشكالًا موضعية متوافقة. بعض ملفات PDF تخزنها كما هي، فيبدو النص سليمًا للعين لكنه مختلف عن النص العادي عند البحث أو المعالجة. تطبيع NFKC يعيد هذه الأشكال إلى الحروف الأساسية.
علامات الاتجاه الخفية
يعرّف UAX #9 محارف تنسيق غير مرئية مثل U+202B وتعني بدء تضمين من اليمين إلى اليسار، وU+202C وتعني إنهاء آخر تضمين. pdftotext أضاف هذه العلامات حول السطور العربية. هي لا تظهر للعين، لكنها تبقى في النص وقد تربك البحث أو المقارنة أو العدّ، لذلك يُفضل حذفها قبل المعالجة.
سكربت تنظيف قبل إرسال النص لأي نموذج
هذا السكربت يجمع خطوات التنظيف التي استخدمناها في القياس، ويضيف فحصًا بسيطًا لاكتشاف أشكال العرض الخاصة:
import re, subprocess, unicodedata
BIDI = re.compile("[--]")
def has_presentation_forms(s):
return any(0xFB50 <= ord(c) <= 0xFDFF or 0xFE70 <= ord(c) <= 0xFEFF for c in s)
def clean(s):
s = BIDI.sub("", s)
s = unicodedata.normalize("NFKC", s)
s = s.replace("ـ", "")
s = re.sub(r"[ \t]+", " ", s)
return re.sub(r"\n{3,}", "\n\n", s).strip()
raw = subprocess.run(["pdftotext", "report.pdf", "-"],
capture_output=True, text=True).stdout
print("presentation forms:", has_presentation_forms(raw))
text = clean(raw)ننبه إلى أن معيار UAX #15 نفسه يحذر من تطبيق تطبيع NFKC بلا تمييز، لأنه يزيل فروقًا قد تكون مقصودة، مثل الأرقام العلوية أو بعض الرموز المركبة. في نصوص التقارير العادية يكون مفيدًا غالبًا، لكن احتفظ بالنسخة الأصلية دائمًا. والسكربت لا يصلح النص المعكوس ولا يعيد الأرقام إلى مواضعها، فهذه أخطاء تُعالج باختيار أداة أفضل.
أي أداة تختار؟ قرار حسب الحالة
| الحالة | ما نوصي به | السبب |
|---|---|---|
| تقرير عربي نصي للتلخيص أو الأسئلة | pdftotext بالوضع الافتراضي ثم سكربت التنظيف | أقل نسبة خطأ في الملفين النصيين |
| تحتاج شكل الأعمدة كما يظهر | pdftotext -layout مع مراجعة ترتيب الأعمدة | يحافظ على الشكل لكن رؤوس الجدول قد تنعكس |
| ملف مصدَّر من Word أو LibreOffice وبيئة بايثون فقط | pypdf مع مراجعة الأرقام والكلمات اللاتينية | خطأ مقبول في هذا النوع وضعيف في ملفات المتصفح |
| استخراج جداول بأدوات pdfplumber | لا تعتمد على النص الافتراضي للعربية | السطور خرجت معكوسة بالإعدادات الافتراضية |
| ملف ممسوح ضوئيًا أو صور فقط | أداة تعرّف ضوئي مثل Tesseract | لا توجد طبقة نصية لتستخرجها أي أداة |
إذا كان النص سيمر إلى أداة تلخيص، فالأولوية لترتيب الكلمات والأرقام لا لشكل الصفحة، وهنا يتفوق pdftotext الافتراضي. أما إذا كنت تستخرج جدولًا لتحليل رقمي، فلا تعتمد على أي أداة دون مطابقة يدوية لعينة من الصفوف، لأن كل الأدوات التي جربناها عاملت الجدول بطريقة مختلفة: سطر لكل خلية، أو خلايا ملتصقة، أو أعمدة بترتيب بصري.
وماذا لو كنت لا تكتب شيفرة؟
لست مضطرًا إلى بايثون لتستفيد من النتائج. أداة pdftotext تأتي ضمن حزمة poppler-utils في توزيعة Ubuntu التي أجرينا عليها التجربة، ويكفي سطر واحد في الطرفية لتحويل الملف إلى نص، مثل pdftotext report.pdf report.txt. بعدها افتح الملف النصي في أي محرر يدعم العربية، وراجع العنوان وأول فقرة فيها أرقام.
وإن كنت تستخدم أداة ذكاء اصطناعي تقبل رفع الملفات مباشرة، فجرّب حيلة بسيطة: اطلب منها أولًا أن تنسخ لك الفقرة الأولى من الملف حرفيًا قبل أي تلخيص. إذا جاءت الفقرة معكوسة أو مختلطة الأرقام، فاعلم أن الملخص سيُبنى على نص مشوه، والأفضل أن تستخرج النص بنفسك وتلصقه بعد تنظيفه.
قبل التلخيص: انسخ لي الفقرة الأولى من الملف المرفق كما هي حرفيًا، دون تعديل أو ترجمة، ثم توقف.حدود هذه التجربة
- صفحة واحدة فقط: نص من نحو 640 حرفًا. الملفات الطويلة متعددة الأعمدة أو ذات الحواشي قد تكشف مشكلات لم تظهر هنا.
- خطان ومصدران للإنتاج: Noto Naskh Arabic عبر Chromium وAmiri عبر LibreOffice. ملفات من InDesign أو برامج أقدم قد تتصرف بشكل مختلف تمامًا.
- إعدادات افتراضية: لم نضبط خيارات الاتجاه في pdfplumber ولا وضع التخطيط في pypdf، وقد تتحسن نتائجهما بالضبط.
- المقياس متساهل: حذفنا علامات الاتجاه وطبّعنا النص قبل الحساب، فالنص الخام قبل التنظيف أسوأ مما تظهره الأرقام.
- الملف الممسوح نظيف: صورة مولدة من الملف الرقمي نفسه، لا ورقة حقيقية مصورة بهاتف بإضاءة سيئة.
اتبعنا في التوثيق المنهج الموضح في كيف نختبر أدوات الذكاء الاصطناعي قبل التوصية بها، ونشجعك على إعادة التجربة على عينة من ملفاتك الفعلية بالشيفرة أعلاه.
قائمة تحقق قبل أن ترسل PDF عربيًا لأداة ذكاء اصطناعي
- افتح الملف وحاول تحديد نص بالفأرة: إن لم تستطع فهو صورة ويحتاج تعرفًا ضوئيًا.
- استخرج النص بأداة pdftotext أو انسخ فقرة واحدة والصقها في محرر نصوص لترى إن كانت معكوسة.
- افحص سطرًا فيه رقم وكلمة إنجليزية، فهذه أكثر المواضع عرضة للخلط.
- نظّف النص من علامات الاتجاه وطبّعه قبل إرساله، واحتفظ بالأصل.
- راجع الجداول يدويًا أو انقلها إلى جدول بيانات بدل الاعتماد على النص المستخرج.
- قسّم الملف الطويل إلى أجزاء منطقية قبل التلخيص، كما شرحنا في تلخيص الملفات الطويلة دون فقد السياق.
- احذف البيانات الحساسة قبل الرفع لأي خدمة سحابية، وراجع قائمة الخصوصية قبل رفع الملفات.
- قارن الملخص بفقرتين أو ثلاث من الأصل، خاصة الأرقام والتواريخ والأسماء.