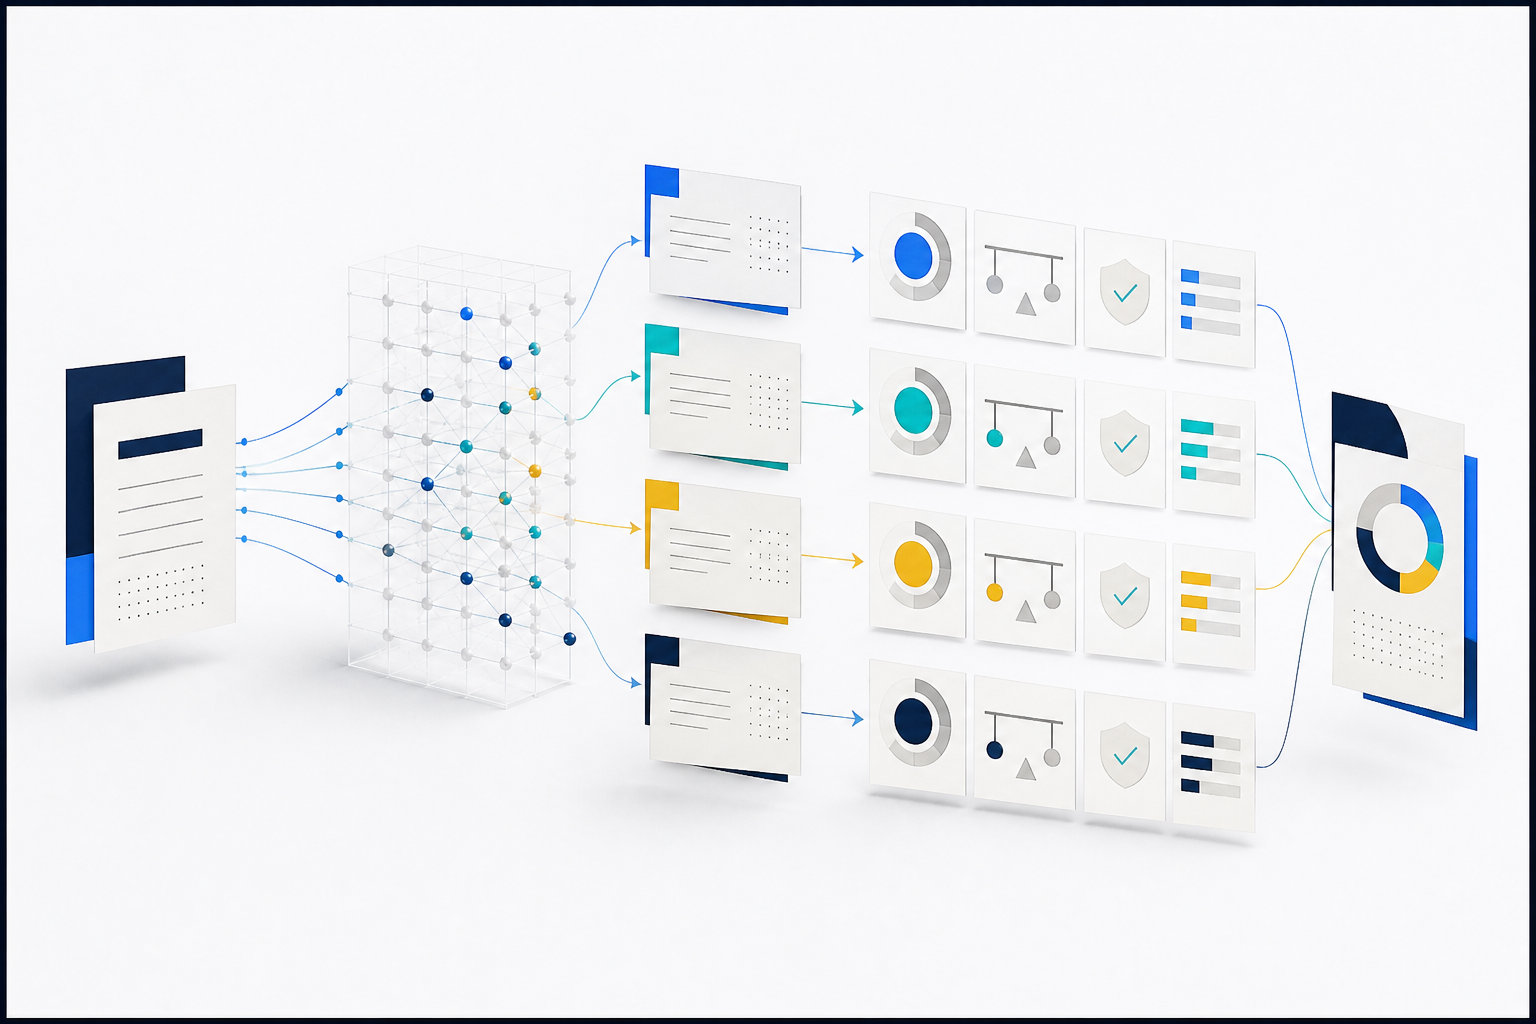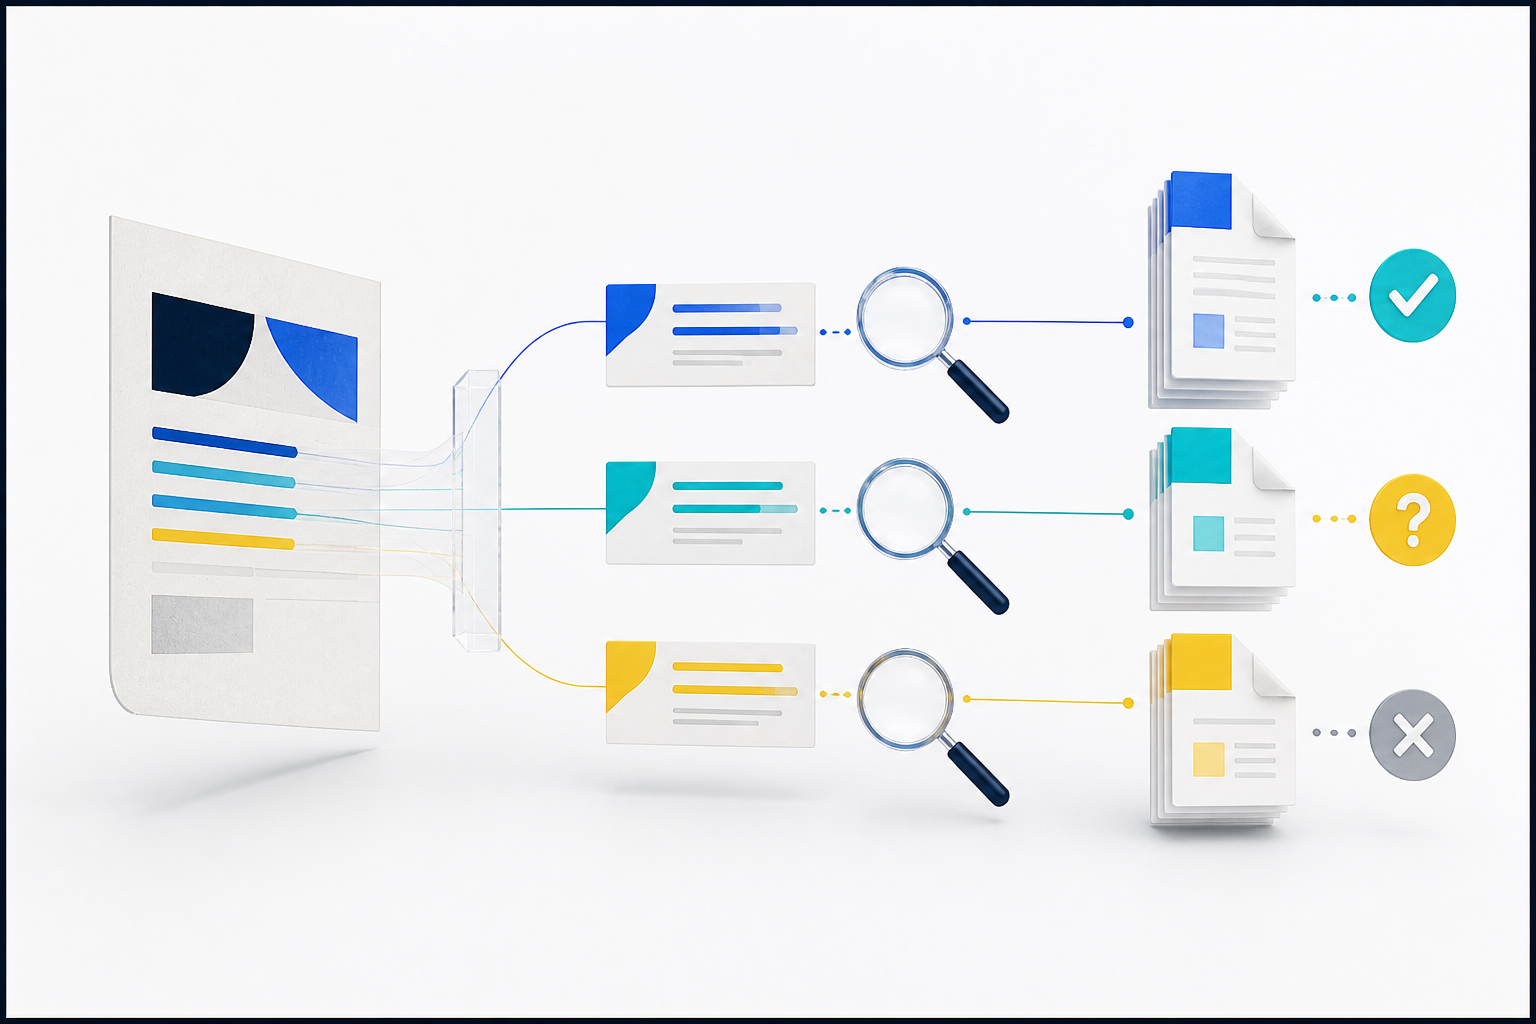
عندما تقرأ في موقعنا أن أداة ما «أخطأت في قراءة الأرقام العربية الهندية» أو أن نصًا عربيًا «استهلك رموزًا أكثر من نظيره الإنجليزي»، من حقك أن تسأل: كيف عرفتم؟ على أي عينة؟ في أي تاريخ؟ وهل أستطيع التأكد بنفسي؟
هذه الصفحة تجيب عن هذه الأسئلة. هي المرجع الذي نعود إليه قبل نشر أي تجربة في قسم الأدوات والتجارب، والمعيار الذي يمكنك أن تحاسبنا عليه.
المبادئ التي نبدأ منها
نختبر مهمة، لا منتجًا. لا نسأل «هل هذه الأداة جيدة؟»، بل «هل تستخرج هذه الأداة نص ملف PDF عربي بترتيب صحيح؟» أو «كم رمزًا تستهلك فقرة عربية مقارنة بترجمتها الإنجليزية؟». السؤال المحدد هو ما يجعل النتيجة قابلة للفحص.
نحدد المعيار قبل أن نرى النتيجة. نكتب ما سنقيسه وكيف سنحكم عليه قبل التشغيل. إذا غيّرنا المعيار بعد رؤية المخرجات، نذكر ذلك صراحة، لأن المعيار المعدّل لاحقًا قد يجامل النتيجة دون قصد.
نفصل الملاحظة عن التفسير. «ظهرت الحروف معكوسة في كل سطر عربي» ملاحظة يمكن لأي شخص أن يتحقق منها. «الأداة لا تدعم العربية» تفسير أوسع من الدليل. ننشر الأولى، ونكتب الثانية فقط إذا كان الدليل كافيًا، ومع حدودها.
ننشر ما لم ينجح. النتائج السلبية والمحايدة جزء من التجربة. حذفها يجعل الأدوات تبدو أكثر ثباتًا مما هي عليه.
نستعمل كلمة «اختبرنا» بحذر. لا نكتبها إلا إذا كان لدينا سجل فعلي للتجربة بالحقول المذكورة في الجدول التالي. ما عدا ذلك نصفه كما هو: شرح، أو قراءة في التوثيق الرسمي، أو طريقة يمكن للقارئ تطبيقها.
هذه المبادئ قريبة مما يوصي به إطار NIST لإدارة مخاطر الذكاء الاصطناعي في وظيفة «القياس» (MEASURE)، التي تدعو إلى عمليات اختبار وتقييم قابلة للتكرار، وإلى توثيق مجموعات الاختبار والمقاييس والأدوات المستخدمة.
الحقول التي نسجلها في كل تجربة
كل تجربة تُنشر في الموقع مرتبطة بسجل يضم الحقول التالية. بعض هذه الحقول يظهر في صندوق خاص أسفل المقال، وبعضها في متن المقال نفسه.
| الحقل | ماذا نسجل فيه | لماذا يهم |
|---|---|---|
| الأداة | الاسم الكامل للأداة أو المكتبة | لتجنب الخلط بين منتجات متشابهة الأسماء |
| الإصدار أو الخطة | رقم الإصدار، أو الخطة المجانية أو المدفوعة، أو اسم النموذج الظاهر | الأدوات تتغير والنتيجة تخص نسخة محددة |
| التاريخ | يوم تشغيل التجربة | لمعرفة متى قد تحتاج النتيجة إلى إعادة |
| البيئة | نظام التشغيل والإعدادات غير الافتراضية | لأن الإعدادات قد تغيّر النتيجة كليًا |
| العينة | وصف النصوص أو الملفات وحجمها ومصدرها | لمعرفة ما تمثله النتيجة وما لا تمثله |
| المعايير | المقياس المستخدم وطريقة حسابه | لإمكانية إعادة الحساب والمقارنة |
| الدليل | الأرقام والجداول ومقتطفات المخرجات | لفصل ما رأيناه عن رأينا فيه |
| القيود | ما لم نختبره وحدود العينة | لمنع تعميم النتيجة خارج نطاقها |
العينة في التجارب العربية تحتاج عناية خاصة. نص فصيح قصير لا يكفي للحكم على أداة ستتعامل مع رسائل عملاء بلهجات مختلفة. لذلك نحاول أن تشمل العينة، حسب السؤال، أرقامًا عربية هندية وغربية، ومصطلحات إنجليزية داخل جمل عربية، ونصوصًا مشكولة وغير مشكولة. ونكتب العينات بأنفسنا أو نستخدم مواد نملك حق استخدامها، ولا نرفع بيانات أشخاص حقيقيين؛ وهي القاعدة نفسها التي نشرحها في قائمة الخصوصية قبل رفع ملف.
كيف نقيس؟
اختيار المقياس يعتمد على المهمة. فيما يلي الطرق التي نستخدمها في أنواع التجارب الأكثر تكرارًا لدينا، وكلها طرق معروفة يمكنك تطبيقها بنفسك.
دقة النص المستخرج: معدل خطأ الحروف
عندما نختبر استخراج النص من ملفات PDF، أو التعرف الضوئي على الحروف (OCR)، أو تفريغ الصوت إلى نص، نحتاج إلى مقارنة مخرج الأداة بنص مرجعي صحيح نعرفه مسبقًا. المقياس الذي نستخدمه هو معدل خطأ الحروف (Character Error Rate)، ويحسب عدد عمليات الإضافة والحذف والاستبدال اللازمة لتحويل المخرج إلى النص المرجعي، مقسومًا على طول النص المرجعي. كلما اقترب الرقم من الصفر كان المخرج أدق.
هذا المقياس متاح في مكتبات مفتوحة المصدر مثل JiWER التي تحسب أيضًا معدل خطأ الكلمات (WER). وفي العربية نوحّد النصين قبل المقارنة: نطبّع أشكال الحروف، ونزيل علامات التحكم في الاتجاه غير المرئية، ونوحد المسافات. ونذكر خطوات التطبيع في كل تجربة، لأن تغييرها يغيّر الرقم. وعندما يكون النص مشكولًا، قد نحسب المعدل مرتين: مرة بالتشكيل ومرة دونه.
التكلفة والسعة: عدد الرموز
النماذج اللغوية لا تقرأ الكلمات بل الرموز (tokens)، وعدد الرموز يحدد تكلفة الاستخدام عبر واجهات البرمجة ومساحة نافذة السياق. لقياس ذلك نشغّل المُرمِّز (tokenizer) الرسمي للنموذج على النص نفسه ونعد الرموز. لنماذج OpenAI مثلًا نستخدم مكتبة tiktoken الرسمية، ولنماذج مفتوحة الأوزان نستخدم ملف المُرمِّز المنشور مع النموذج.
نقارن عادة نصوصًا متوازية، أي النص نفسه بالعربية والإنجليزية، حتى يكون الفرق في اللغة لا في المحتوى. ولا نحوّل عدد الرموز إلى سعر إلا بعد مراجعة صفحة الأسعار الرسمية في يوم الكتابة، ونذكر ذلك التاريخ بجانب الرقم. شرح الرموز نفسها موجود في كيف تعمل النماذج اللغوية الكبيرة.
المهام المفتوحة: معايير مكتوبة مسبقًا
بعض المهام لا يوجد لها رقم واحد، مثل جودة ملخص أو مناسبة نبرة رسالة. هنا نكتب قبل التجربة قائمة بما يجب أن يظهر، وما لا يجوز أن يظهر، ونحكم على كل مخرج وفقها. نكرر المهمة في جلسات جديدة لرؤية التذبذب، لأن مخرجات النماذج غير حتمية. والطريقة مفصلة في كيف تختبر مساعد كتابة قبل اعتماده.
مثال: من سؤال إلى سجل تجربة
لنفترض أن قارئًا يعمل في محاسبة شركة صغيرة بالكويت سألنا: هل أستطيع الاعتماد على أداة مجانية لاستخراج نص فواتير الموردين العربية الممسوحة ضوئيًا؟ هذا سؤال واسع، فنبدأ بتضييقه: أي نوع من الفواتير؟ وما الحقول التي تهمه فعلًا؟ غالبًا تكون اسم المورد والتاريخ والمبلغ ورقم الفاتورة.
بعد ذلك نصمم العينة. نكتب فواتير تجريبية بأسماء وأرقام وهمية، بعضها بأرقام عربية هندية وبعضها بأرقام غربية، وبخطوط مختلفة وأحجام مختلفة، ثم نحولها إلى صور كأنها ممسوحة ضوئيًا. ولأننا كتبنا الفواتير بأنفسنا، فلدينا النص المرجعي الصحيح لكل منها.
سجل تجربة (نموذج فارغ)
السؤال:
الأداة والإصدار أو الخطة:
تاريخ التشغيل:
البيئة والإعدادات غير الافتراضية:
العينة (العدد، المصدر، الخصائص):
المقياس وطريقة الحساب وخطوات التطبيع:
النتائج (جدول + مقتطفات من المخرجات):
ما لم نختبره:
ثم نحدد المعيار قبل التشغيل: معدل خطأ الحروف للنص كله، ونسبة الحقول الأربعة التي استُخرجت صحيحة تمامًا. الحقل الثاني مهم لأن خطأ حرف واحد في المبلغ أخطر من عشرة أخطاء في عنوان الشركة، والمعدل العام وحده لا يكشف ذلك.
أخيرًا نكتب النتيجة بحدودها: هذه الأرقام تخص فواتير نظيفة مطبوعة، ولا تشمل الفواتير المكتوبة بخط اليد أو الصور الملتقطة بالهاتف بزاوية مائلة. إذا كانت هذه حالة القارئ فعلًا، فنتيجتنا لا تجيب عن سؤاله بعد، ونقول ذلك صراحة.
ما الذي نرفض فعله؟
- لا ننشر محتوى مدفوعًا على أنه تجربة. لا تستطيع أي جهة أن تدفع مقابل ظهور أداتها في تجاربنا أو مقابل ترتيبها.
- لا ندعي نتيجة بلا دليل. إذا لم يكن لدينا سجل للتجربة، لا نكتب أننا جربنا.
- لا نخفي علاقة تجارية. إذا حصلنا على وصول مجاني أو رابط إحالة، نفصح عنه بجانب المحتوى المعني، لا في صفحة جانبية.
- لا نعمم من عينة صغيرة. نصف النتيجة بأنها مؤشر عندما تكون العينة محدودة، ونذكر حجمها.
- لا نحوّل التوثيق إلى نتيجة اختبار. إذا قالت صفحة المزود إن الأداة تدعم العربية، ننسب ذلك إلى الصفحة، ولا نقدمه كأنه شيء لاحظناه.
- لا نختبر على بيانات أشخاص حقيقيين أو ملفات لا نملك حق رفعها.
الإفصاح عن العلاقات التجارية ليس اجتهادًا تحريريًا فقط. إرشادات لجنة التجارة الفيدرالية الأمريكية (FTC) بشأن التوصيات مثلًا تطلب الإفصاح الواضح عن أي علاقة مادية، مثل الدفع أو المنتجات المجانية أو عمولات الإحالة، في مكان يلاحظه القارئ. نطبق المبدأ نفسه على قرائنا العرب أيًا كان البلد الذي يقرؤون منه.
حدود ما نستطيع قوله
أي تجربة تحريرية محدودة بطبيعتها. عينتنا صغيرة مقارنة بالمعايير البحثية، وبيئتنا قد تختلف عن بيئتك، والأدوات تتحدث باستمرار أحيانًا دون أن يتغير اسمها. النتيجة التي ننشرها صحيحة للنسخة والتاريخ والعينة المذكورة، ولا شيء أكثر.
يذكّر ملف NIST لمخاطر الذكاء الاصطناعي التوليدي بأن هذه الأنظمة قد تنتج مخرجات واثقة لكنها خاطئة، وهو ما يجعل التحقق جزءًا من الاستخدام لا خطوة إضافية. لذلك نشجعك على التعامل مع نتائجنا كنقطة انطلاق لاختبارك أنت، خصوصًا قبل قرار مهم. وطرق مراجعة المخرجات بنفسك مشروحة في كيف تراجع إجابة الذكاء الاصطناعي قبل أن تعتمدها.
متى نعيد التجربة؟ عندما يتغير الإصدار أو الخطة بشكل يمس السؤال، أو عندما يرسل لنا قارئ حالة لم تغطها العينة، أو عندما نجد خطأً في طريقتنا. ونسجل تاريخ إعادة الاختبار منفصلًا عن تاريخ النشر الأصلي. تغيير تاريخ الصفحة وحده لا يعني أن المحتوى صار حديثًا؛ الحداثة الحقيقية أن تُعاد التجربة على النسخة الجديدة، وأن تُنشر نتيجتها حتى لو جاءت مطابقة للنتيجة السابقة.
وعندما لا نستطيع إعادة التجربة، لأن الأداة توقفت أو تغيرت خطتها المجانية مثلًا، نضيف ملاحظة واضحة في أعلى المقال بأن النتيجة تخص نسخة سابقة، بدل أن نترك القارئ يفترض أنها ما زالت صالحة.
كيف تعيد تجاربنا أو تعترض عليها؟
ننشر مع كل تجربة ما يكفي لإعادتها: وصف العينة، وأسماء الأدوات وإصداراتها، وخطوات التطبيع، وطريقة حساب المقياس. إذا أعدت التجربة وحصلت على نتيجة مختلفة، فهذا مفيد لنا ولبقية القراء.
- اقرأ صندوق المنهجية أسفل التجربة، وسجّل الأداة والإصدار والتاريخ.
- جهّز عينة مشابهة، أو استخدم وصف عينتنا لكتابة عينة مماثلة.
- شغّل الأداة بالإعدادات نفسها، وسجّل أي اختلاف في بيئتك.
- احسب المقياس بالطريقة الموصوفة، واحتفظ بالمخرجات.
- راسلنا عبر صفحة التواصل مع وصف ما فعلته وما وجدته، دون إرسال أي بيانات شخصية أو سرية.
نراجع كل اعتراض موثق. إذا ثبت أن نتيجتنا خاطئة أو صارت قديمة، نصحح المقال ونذكر التصحيح وتاريخه في الصفحة نفسها، ولا نحذف النسخة السابقة بصمت. وإذا لم نتفق مع الاعتراض، نشرح السبب. ونرحب أيضًا باقتراحات العينات: إذا كانت لديك حالة عربية شائعة في عملك لم تغطها تجاربنا، مثل جداول بأرقام مختلطة أو نصوص بلهجة محلية، فصفها لنا بأمثلة وهمية، وقد تصبح جزءًا من التجربة التالية.