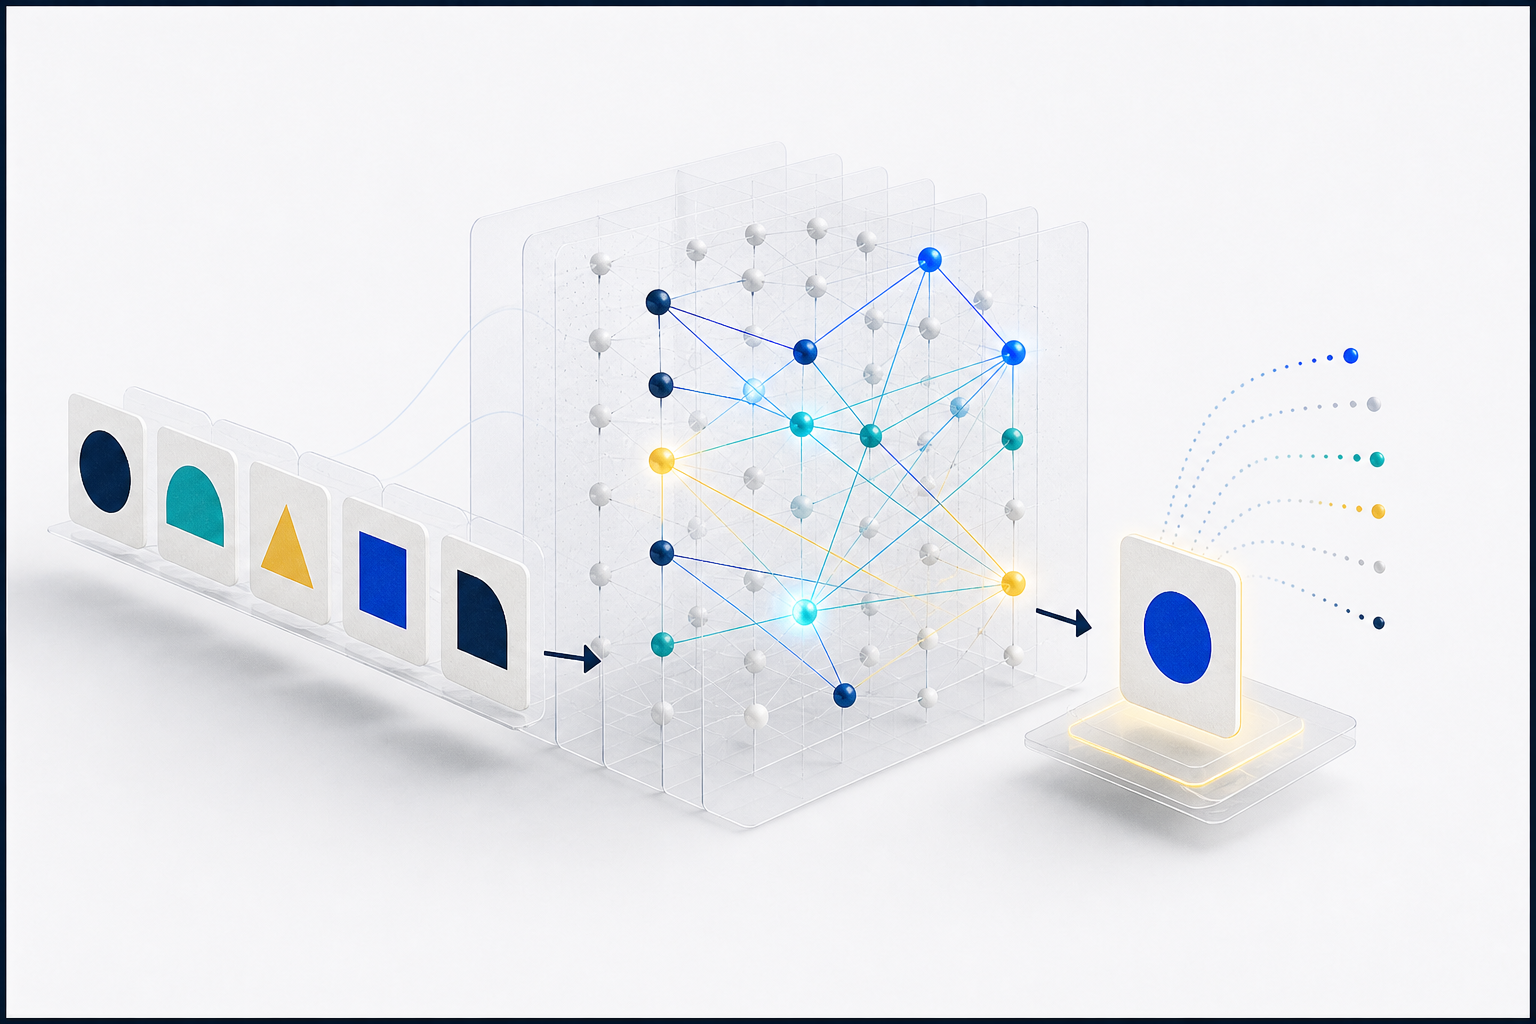
تكتب موظفة في شركة توزيع بالدار البيضاء رسالة لزميلها، وتتوقف عند منتصف الجملة: «أرجو إرسال التقرير الشهري قبل نهاية». قبل أن تكمل، يقترح عليها البريد كلمة «الأسبوع». كيف عرف؟
النموذج اللغوي الكبير (Large Language Model) يفعل الشيء نفسه على نطاق أوسع بكثير. هو في جوهره آلة تقدّر ما الذي يأتي بعد ما كُتب، ثم تكرر ذلك مرة بعد مرة حتى يكتمل الرد. يصف مقرر Google التعليمي النماذج الكبيرة بأنها في الأساس آليات إكمال تلقائي تتنبأ بآلاف الرموز.
لن نتحدث هنا عن الرياضيات. سنتابع جملة الموظفة نفسها، خطوة بخطوة، من لحظة الإدخال إلى لحظة ظهور الكلمة على الشاشة. وفي النهاية ستجد قائمة مراجعة تحوّل هذا الفهم إلى عادات استخدام يومية، سواء كنت تكتب رسالة عمل أو تلخص بحثًا جامعيًا أو تجهز تقريرًا شهريًا.
الخطوة الأولى: تقطيع الجملة إلى رموز
النموذج لا يرى الحروف والكلمات كما نراها. أول ما يحدث هو تحويل النص إلى وحدات تسمى الرموز (tokens). بحسب مسرد مصطلحات Anthropic، الرمز هو أصغر وحدة يتعامل معها النموذج، وقد يقابل كلمة كاملة أو جزءًا منها أو حرفًا أو حتى بايتًا.
لنفترض، على سبيل التوضيح فقط، أن جملتنا قُطّعت هكذا: «أرجو» | «إرسال» | «ال» | «تقرير» | «ال» | «شهري» | «قبل» | «نهاية». لاحظ أن أداة التعريف قد تنفصل عن الكلمة. التقطيع الفعلي يختلف من نموذج لآخر لأن لكل نموذج معجم رموز خاصًا به.
بعد التقطيع يتحول كل رمز إلى رقم، ثم إلى تمثيل رقمي أغنى يحمل شيئًا من معناه وعلاقته بغيره. من هنا فصاعدًا، كل ما يفعله النموذج هو عمليات على هذه الأرقام.
الخطوة الثانية: قراءة السياق كاملًا
الرمز الأخير «نهاية» وحده لا يكفي للتخمين. نهاية ماذا؟ الفيلم؟ الطريق؟ النماذج الحديثة تنظر إلى كل الرموز السابقة معًا وتقدّر أيها أهم لفهم الموضع الحالي، عبر آلية تسمى الانتباه الذاتي (self-attention).
في جملتنا، كلمتا «التقرير» و«الشهري» تحملان وزنًا كبيرًا. وجود «الشهري» يجعل «الشهر» احتمالًا واردًا، ووجود «أرجو إرسال» يوحي بسياق عمل فيه مواعيد تسليم. لو كانت الجملة جزءًا من محادثة أطول ذُكر فيها اجتماع يوم الخميس، لتغير التقدير مرة أخرى.
هذا هو المقصود بالسياق (context): كل ما يراه النموذج في اللحظة الحالية، بما في ذلك تعليماتك، والملفات التي أرفقتها، وما سبق في المحادثة، وما كتبه النموذج نفسه حتى الآن.
الخطوة الثالثة: حساب احتمالات الرمز التالي
بعد قراءة السياق، يُخرج النموذج قائمة بكل الرموز الممكنة في معجمه، ولكل منها احتمال. يشرح مقرر Google عن النماذج اللغوية هذه الفكرة بمثال يضع نسبة مئوية أمام كل كلمة مرشحة لملء الفراغ.
الجدول التالي توضيحي بالكامل. الأرقام فيه افتراضية وضعناها لشرح الفكرة، ولا تمثل مخرجات أي نموذج حقيقي.
| الرمز المرشح | احتمال افتراضي | لماذا قد يرتفع أو ينخفض |
|---|---|---|
| الأسبوع | 0.46 | تركيب شائع جدًا في رسائل العمل |
| الشهر | 0.27 | كلمة الشهري في السياق ترفعه |
| اليوم | 0.12 | شائع في الطلبات العاجلة |
| الدوام | 0.08 | مستخدم في رسائل العمل بالخليج والمشرق |
| الربع | 0.03 | ممكن في سياق التقارير المالية |
| بقية المعجم مجتمعة | 0.04 | آلاف الرموز باحتمالات ضئيلة |
لاحظ أن النموذج لا «يعرف» الإجابة الصحيحة. لا توجد إجابة صحيحة أصلًا؛ هناك فقط تقديرات لما هو مألوف في سياق كهذا، بناءً على أنماط تعلمها أثناء التدريب المسبق (pretraining) على كميات ضخمة من النصوص.
الخطوة الرابعة: اختيار رمز ثم تكرار الدورة
الآن يجب اختيار رمز واحد. لو اختار النموذج دائمًا الأعلى احتمالًا، لكانت ردوده متطابقة ومملة. لذلك تستخدم أغلب الأدوات طريقة اختيار فيها قدر من العشوائية تسمى أخذ العينات (sampling). المسرد السابق يعرّف درجة الحرارة (temperature) بأنها معامل يتحكم في عشوائية تنبؤات النموذج أثناء التوليد.
بدرجة حرارة منخفضة، يكاد النموذج يختار «الأسبوع» في كل مرة. وبدرجة أعلى، قد يختار «الدوام» أو «الربع» أحيانًا. هذا يفسر لماذا تحصل على ردين مختلفين للسؤال نفسه، وهي ظاهرة تشير إليها صفحة مساعدة OpenAI عن تطوير نماذجها أيضًا، إذ تذكر أن أكثر من استمرار واحد قد يكون معقولًا للسؤال نفسه.
بعد اختيار «الأسبوع»، يُضاف الرمز إلى السياق وتبدأ الدورة من جديد: قراءة السياق الأطول، حساب احتمالات جديدة، اختيار رمز آخر. ربما تأتي نقطة، أو «لأنني»، أو «حتى». وهكذا، رمزًا بعد رمز، يتكون الرد كله.
النتيجة المهمة: النموذج لا يخطط للفقرة كاملة ثم يكتبها كما يفعل الإنسان عادة. كل رمز يُبنى على ما سبقه، بما في ذلك الرموز التي اختارها هو نفسه. إذا انحرف مبكرًا نحو معلومة خاطئة، فقد يواصل البناء عليها بثقة. نشرح هذا الأثر في مقال لماذا يختلق الذكاء الاصطناعي إجابات مقنعة.
ما الذي يحدث قبل أن تكتب أنت أي شيء؟
الرحلة التي تابعناها تحدث في لحظة الاستخدام. لكن قدرة النموذج على تقدير «الأسبوع» بعد «قبل نهاية» تكونت قبل ذلك بكثير، في مرحلتين رئيسيتين.
المرحلة الأولى هي التدريب المسبق: يرى النموذج كميات هائلة من النصوص، ويتدرب على تخمين الرمز التالي فيها، ويعدّل أرقامه الداخلية بعد كل خطأ. صفحة OpenAI توضح أن النموذج لا يخزّن نسخًا من النصوص التي تدرب عليها، بل يعدّل معاملات رقمية تمثل الأنماط. لهذا لا يستطيع عادة أن يخبرك من أي مصدر جاءت معلومة بعينها.
المرحلة الثانية هي الضبط اللاحق، ومن أشهر تقنياته التعلم المعزز من الملاحظات البشرية (RLHF)، الذي يعرّفه مسرد Anthropic بأنه تدريب النموذج على التصرف بما يتسق مع تفضيلات البشر. هذه المرحلة هي التي تجعل النموذج يجيب كمساعد مهذب بدل أن يكمل النص فقط. لكنها لا تضيف إليه معرفة بالأحداث التي وقعت بعد جمع بيانات تدريبه.
ما الذي لا يحدث داخل النموذج؟
من المفيد أيضًا أن تعرف ما ليس جزءًا من هذه الرحلة. النموذج وحده لا يفتح الإنترنت أثناء الرد، ولا يراجع قاعدة بيانات للتأكد من صحة رقم، ولا يتذكرك من محادثة سابقة ما لم تضف الأداة ذاكرة أو بحثًا كطبقة خارجية. بعض المنتجات تضيف هذه الطبقات فعلًا، لكنها إضافات حول النموذج لا جزء من آلية التنبؤ نفسها.
لهذا، حين ترى أداة تعرض روابط أو تقول إنها بحثت، فاسأل: هل الرد مبني على ما في هذه الروابط فعلًا؟ افتحها وتحقق، ولا تفترض أن وجود الرابط يعني أن كل جملة مدعومة به.
نافذة السياق: لماذا تنسى المحادثة الطويلة تفاصيلها؟
نافذة السياق (context window) هي مقدار النص الذي يستطيع النموذج أن ينظر إليه ويستند إليه أثناء توليد الرد. كل شيء يدخل فيها: تعليماتك، والمستندات، وتاريخ المحادثة، والرد الجاري. صفحة OpenAI عن الرموز توضح أن رموز الإدخال والإخراج تُحتسب معًا في الاستخدام، وأن للإخراج حدًا مستقلًا.
النافذة تُقاس بالرموز لا بالصفحات ولا بالكلمات. وحجمها يختلف من نموذج لآخر، لذلك راجع توثيق الأداة التي تستخدمها بدل الاعتماد على رقم سمعته في نقاش عابر. حين تمتلئ، تتعامل الأدوات مع ذلك بطرق مختلفة: بعضها يرفض الطلب، وبعضها يقتطع الأجزاء الأقدم، وبعضها يلخصها. وحتى قبل الامتلاء، قد يعطي النموذج وزنًا أقل لتفصيل ورد في منتصف مستند طويل. لهذا نوصي بتقسيم الملفات الكبيرة كما نشرح في تلخيص الملفات الطويلة دون فقد السياق.
لماذا قد يستهلك النص العربي رموزًا أكثر؟
معاجم الرموز تُبنى إحصائيًا من بيانات التدريب. إذا كانت نسبة النص الإنجليزي في تلك البيانات أكبر بكثير، فستحصل الكلمات الإنجليزية الشائعة على رموز كاملة، بينما تُقطّع الكلمات العربية إلى أجزاء أصغر. النتيجة أن الجملة نفسها قد تحتاج رموزًا أكثر بالعربية.
دراسة Petrov وزملائه المنشورة في مؤتمر NeurIPS 2023 وجدت أن ترجمة النص نفسه إلى لغات مختلفة قد تغيّر عدد رموزه تغييرًا كبيرًا، حتى في المقطِّعات المصممة لتعدد اللغات. ويشير الباحثون إلى ثلاث عواقب: تكلفة أعلى، وبطء أكبر، ومساحة أقل في نافذة السياق لمتحدثي بعض اللغات. وصفحة OpenAI عن الرموز تنبه بدورها إلى أن القاعدة التقريبية للإنجليزية قد لا تنطبق على لغات أخرى، وتنصح بالاختبار على نصك.
في العربية تحديدًا، هناك عوامل يُتوقع أن تؤثر في عدد الرموز وتستحق الانتباه:
- التشكيل الكامل يضيف علامات قد يقطّعها النموذج كرموز مستقلة.
- الأرقام العربية الهندية مثل ٢٠٢٦ قد تُعامل بشكل مختلف عن 2026.
- خلط الفصحى بالعامية أو بالمصطلحات الإنجليزية يغير طريقة التقطيع.
- اختلاف المقطِّع بين نموذج وآخر قد يكون أكبر من اختلاف اللغة نفسها.
لا نذكر هنا أرقامًا محددة، لأن النسبة تتغير بحسب النموذج ونوع النص. إذا كانت التكلفة أو طول السياق مهمين لعملك، فاختبر نصوصك الفعلية بأداة العدّ التي يوفرها مزود الخدمة.
ما الذي يعنيه هذا لك عمليًا؟
الآن وقد تابعت رحلة الجملة، يمكنك تحويل الفهم إلى عادات استخدام. هذه قائمة مراجعة قصيرة:
- اكتب السياق المهم في طلبك صراحة، لأن النموذج يبني على ما يراه لا على ما في ذهنك.
- ضع التعليمات الأساسية في بداية الطلب، وكررها باختصار في المحادثات الطويلة.
- اعتبر اختلاف الرد بين محاولتين أمرًا طبيعيًا في الصياغة، ومؤشرًا للتحقق في الحقائق.
- لا تعامل الطلاقة اللغوية كدليل على صحة المعلومة؛ الاحتمال العالي يعني «مألوف» لا «صحيح».
- قسّم المستندات الطويلة إلى أجزاء واضحة العناوين بدل إرسالها دفعة واحدة.
- تجنب التشكيل الكامل في الطلبات إلا حيث يلزم لرفع اللبس، واختبر أثره إن كانت التكلفة تهمك.
- ابدأ محادثة جديدة حين يتغير الموضوع، حتى لا يختلط سياق قديم بمهمة جديدة.
- استخدم قالبًا ثابتًا لطلباتك المتكررة، مثل قالب البرومبت العربي القابل لإعادة الاستخدام.
وإذا أردت تطبيق هذا الفهم على كتابة طلبات أفضل، فدليل السياق والمهمة وشكل الإجابة هو الخطوة التالية المنطقية.