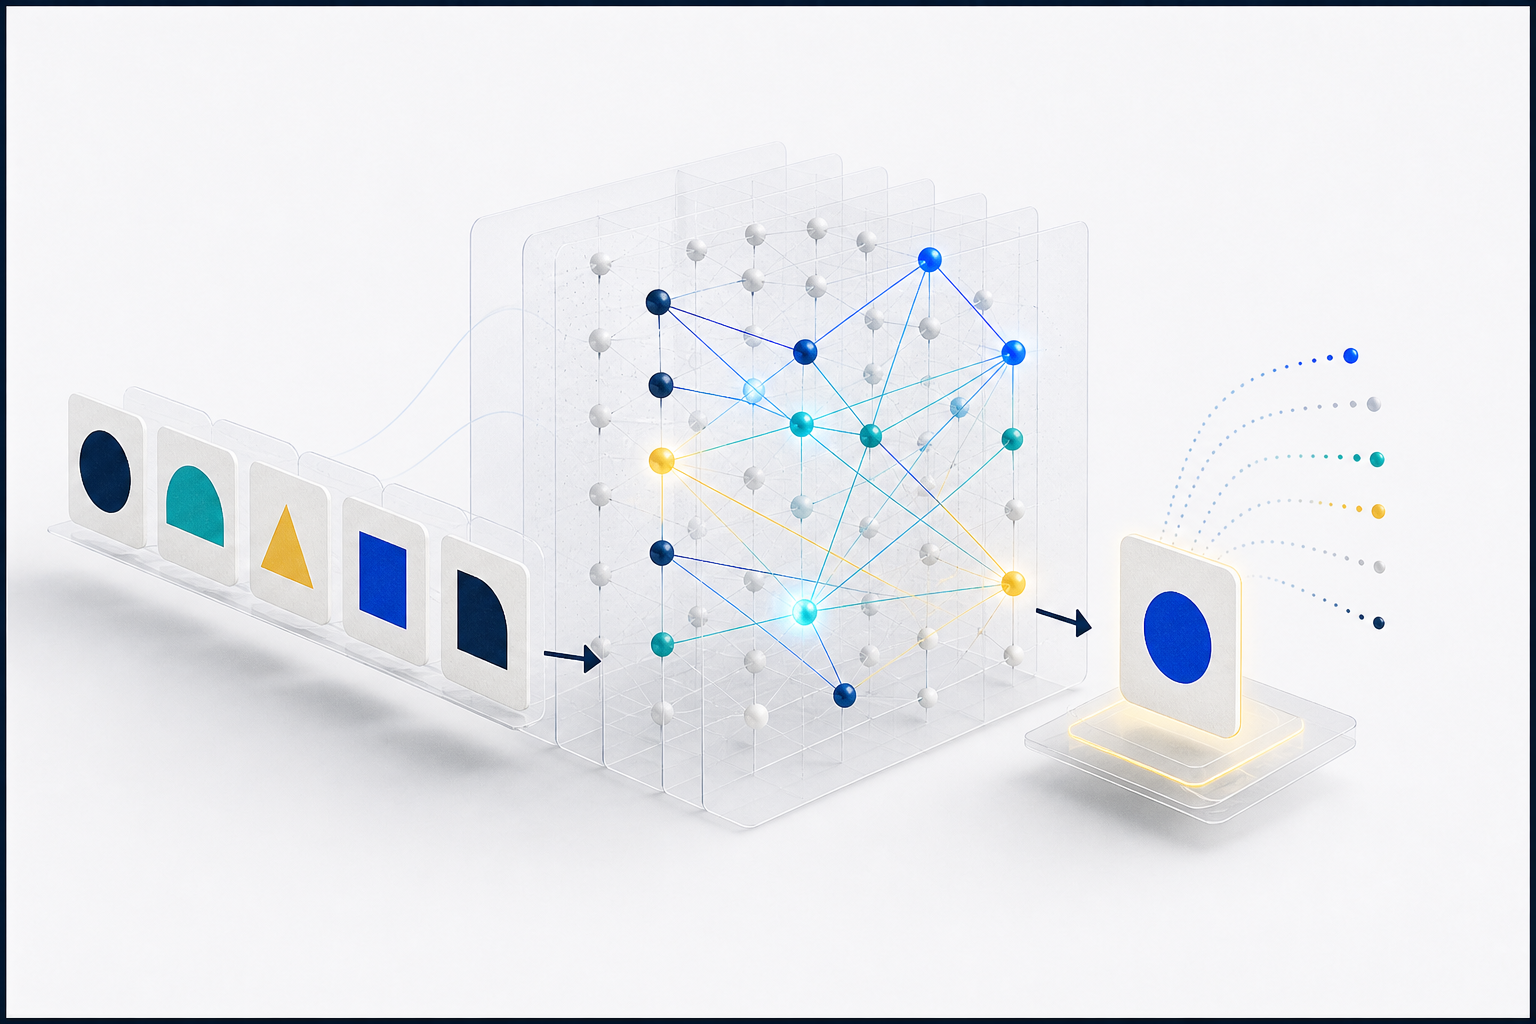
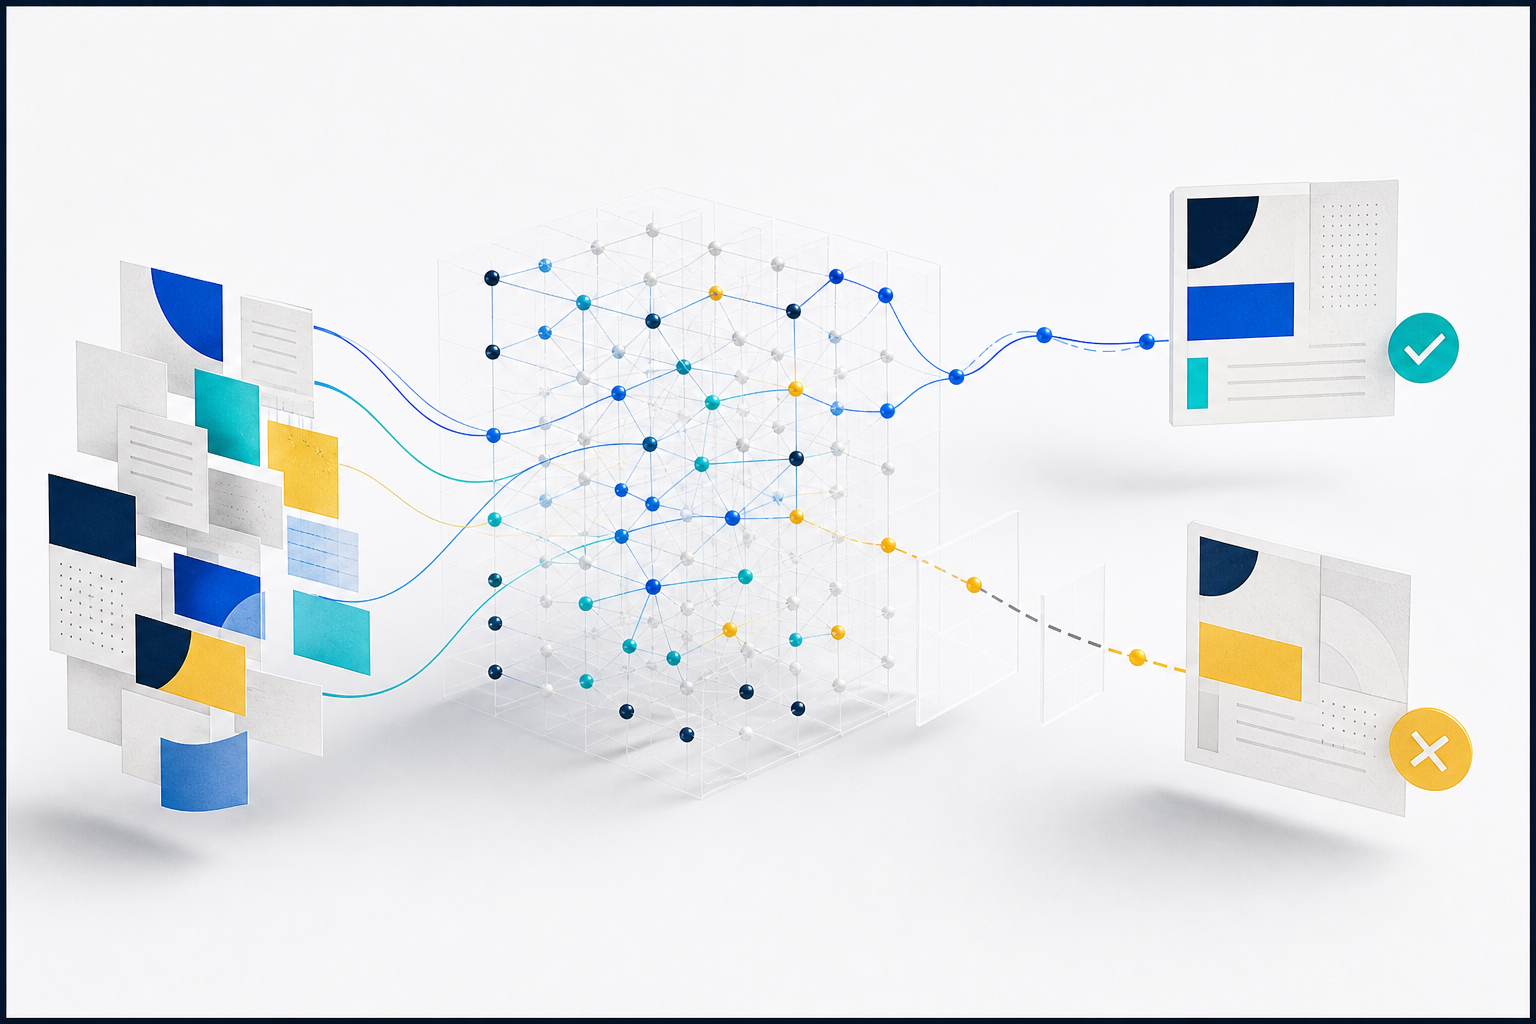
نتابع جملة عربية واحدة داخل النموذج اللغوي: تقطيعها إلى رموز، وقراءة السياق، وحساب الاحتمالات، ثم اختيار الكلمة التالية، مع ما يعنيه ذلك لاستخدامك اليومي.
منهج فريق تحرير World Speaks AI في اختبار الأدوات: المبادئ، والحقول التي نسجلها في كل تجربة، وطرق القياس، وما نرفض فعله، وكيف تعيد التجربة أو تعترض عليها.
جدول يقارن الشات بوت ومحرك البحث في ثمانية معايير، وستة مواقف عربية واقعية مع الاختيار الأنسب وسببه، وشرح لأوضاع البحث المدعومة بالذكاء الاصطناعي، وأسئلة قرار سريعة.
صنّف ملفك بالأحمر والأصفر والأخضر، وراجع عشرة أسئلة قبل الرفع، وتعلّم إخفاء الأسماء والأرقام بمثال قبل وبعد، مع شرح لإعدادات التدريب في ChatGPT وClaude.
مثال تطبيقي كامل لتدقيق إجابة ذكاء اصطناعي: تفكيكها إلى أربعة ادعاءات، والبحث عن المصدر المناسب لكل منها، وجدول حكم وإجراء، ثم تقنية القراءة الجانبية وأخطاء شائعة.
ما الذي تدفع مقابله في خطط مساعدات الذكاء الاصطناعي: الحدود والنماذج وشروط البيانات وميزات الفرق، مع جدول لثلاثة مساعدين حتى أكتوبر 2026 ومثال حساب لمستقل.
مقارنة بين تشغيل الذكاء الاصطناعي في السحابة وعلى جهازك في سبعة معايير، مع متطلبات الأجهزة كما تذكرها الوثائق الرسمية، وثلاث حالات عربية، وقائمة فحص قبل التحول إلى المحلي.